Domain cilg.de kaufen?
Wir ziehen mit dem Projekt
cilg.de um.
Sind Sie am Kauf der Domain
cilg.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain cilg.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **

Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Pokémon Mega Entwicklung - BoosterTrommle deine Verbündeten zusammen und erlebe spannende Abenteuer in dieser heiß erwarteten Erweiterung. Lieferumfang: Ein Booster mit 10 Karten (darunter 3 Holokarten), sowie eine weitere Online-Code Karte5,99 €*Versand: 6,95 €Sichere Weiterleitung zum Anbieter

-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **

Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
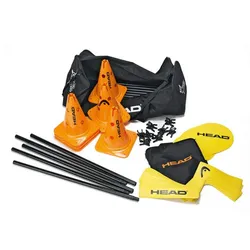
Head - Coaching Starter PacketBESCHREIBUNGUm laufen zu können, muss man zuerst gehen lernen. Und man muss mehr alsnur Vorhand spielen können, um ein perfekter Allrounder zu werden. DasCOACHING PACK ist ein perfekter Partner für jede Art von Training, vonTennis- über Fitness- bis Koordinationseinheiten. Die Tasche enthält 6große Kegel, 12 Stangen mit 8 Clips, 12 Linien, 4 Ecken, 6 Ziele, 1kleine Tasche, um alles tragen zu können, sowie 1 HEAD Coaching Poster,das in Zusammenarbeit mit Trainern erstellt wurde und zeigt, wie man all die tollen Dinge perfekt einsetzt. Dem Training steht also nichts mehrim Wege. Deine Schützlinge werden es dir später einmal danken.119,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Sungrow Kommunikation Datenlogger COM100DDie COM100D-EU Smart Communication Box enthält die Hardware- und Softwarefunktionen des Logger1000A-EU und unterstützt verschiedene Netzwerk-Verbindungsmöglichkeiten. Das äußerst zuverlässige Gerät bietet dedizierte Überspannungsschutzfunktionen und ist dank Schutzart IP 66 für eine Installation im Freien geeignet.614,03 €*Versand: 8,50 €Sichere Weiterleitung zum Anbieter
-
Pokémon Mega Entwicklung - BoosterTrommle deine Verbündeten zusammen und erlebe spannende Abenteuer in dieser heiß erwarteten Erweiterung. Lieferumfang: Ein Booster mit 10 Karten (darunter 3 Holokarten), sowie eine weitere Online-Code Karte5,99 €*Versand: 6,95 €Sichere Weiterleitung zum Anbieter
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
Ähnliche Suchbegriffe für Datenquellen
-
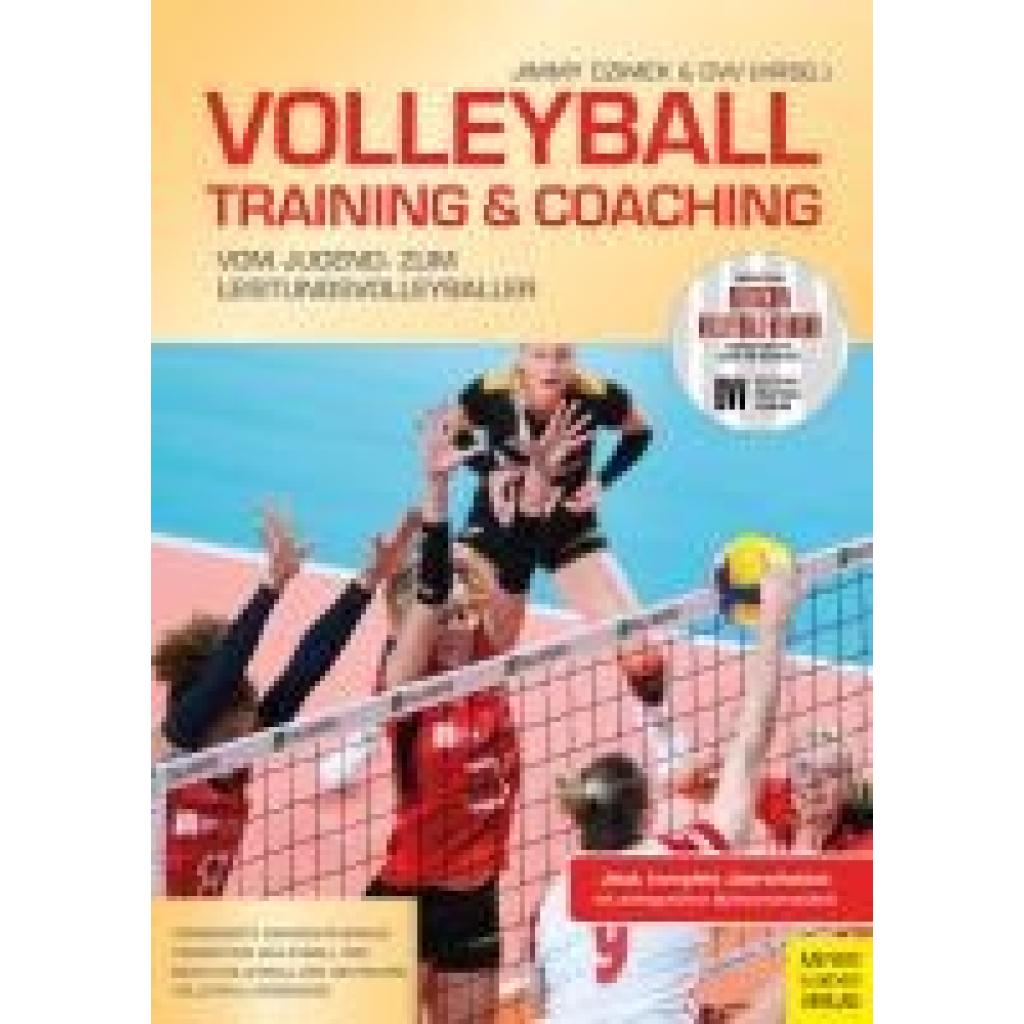
Volleyball - Training und CoachingVolleyball - Training und Coaching , In enger Zusammenarbeit mit zahlreichen deutschen Spitzenvolleyballtrainern und weiteren Fachleuten hat Hauptautor und Herausgeber Dr. Jimmy Czimek einen Leitfaden entwickelt, der die Trainingsgrundlage für sämtliche Jugend- und Juniorenspielklassen von U12 bis U23 im Volleyball und Beachvolleyball bildet. Das umfangreiche Konzept deckt neben dem Technik-, Taktik- und Athletiktraining auch die Trainingsplanung und -dokumentation, das Coaching, die Spielbeobachtung sowie das psychologische Training und den Ernährungsbereich ab. Im Sinne der kombinierten Ausbildung verbindet es dabei die gleichzeitige Entwicklung des Athleten in den beiden Sportarten Volleyball und Beachvolleyball. ¿ Ausbildungswerk für die C-/B- und A-Trainerausbildung ¿ Verdeutlichen der Spielstruktur des Volleyball und Beachvolleyballspiels mit Zahlen aus dem nationalen und internationalen Spitzenbereich ¿ Veranschaulichung zahlreicher Spieltechniken durch Bildreihen mit über 1.600 Fotos ¿ Visualisierung der Spielsysteme sowie der Taktiken in Annahme, Block- und Feldverteidigung und Angriffssicherung in über 1.000 Abbildungen ¿ Erstmalige Darstellung sämtlicher Spielsysteme im Kleinfeldspiel 2 vs. 2 (U12), 3 vs. 3 (U13) und 4 vs. 4 (U14) ¿ Veranschaulichung der gängigsten Spielsysteme im Großfeldspiel 6 vs. 6 (U16 bis Erwachsenenbereich) ¿ Ausführliche Besprechung der Individualtaktik sämtlicher Spielelemente ¿ Praxisnahes Aufzeigen der athletischen Ausbildung von Volleyballspielern ¿ Darstellung der Basistaktiken im Beachvolleyball ¿ Aufzeigen der Synergieeffekte zwischen Volleyball und Beachvolleyball ¿ Praxisnahe Erläuterung der Talentsichtung , Zündkabel & Zündspulenstecker > Zünd- & Glühanlagen , Auflage: 3. Auflage, Erscheinungsjahr: 20250519, Redaktion: Czimek, Jimmy~Deutscher Volleyball-Verband, Edition: REV, Auflage: 25003, Auflage/Ausgabe: 3. Auflage, Seitenzahl/Blattzahl: 640, Themenüberschrift: SPORTS & RECREATION / Volleyball, Keyword: Buch für Volleyballtrainer; Volleyball Coaching; Volleyball Training; Volleyball Training & Coaching; Volleyball Trainingsbuch; Volleyballtechniken; Volleyballtraining Kinder; Volleyballtraining Übungen; Übungen für Volleyballtrainer, Fachschema: Sport / Kindersachbuch, Jugendsachbuch~Volleyball - Beach-Volleyball, Altersempfehlung / Lesealter: 18, ab Alter: 6, Warengruppe: HC/Ballsport, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 297, Breite: 210, Höhe: 44, Gewicht: 2454, Produktform: Kartoniert, Genre: Sachbuch/Ratgeber,62,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Roth, Gerhard: Coaching, Beratung und GehirnCoaching, Beratung und Gehirn , Neurobiologische Grundlagen wirksamer Veränderungskonzepte , Karosserie-Kits > Karosserie & Exterieur Styling , Auflage: 5., durchgesehene und um ein Vorwort erweiterte Auflage 2022, Erscheinungsjahr: 202201, Produktform: Kartoniert, Autoren: Roth, Gerhard~Ryba, Alica, Auflage: 22005, Auflage/Ausgabe: 5., durchgesehene und um ein Vorwort erweiterte Auflage 2022, Seitenzahl/Blattzahl: 386, Keyword: Beratungsgespräch; Beratungspraxis; Coach; Coaching; Coaching-Interventionen; Coachingforschung; Coachingkompetenz; Einzelcoaching; Gedächtnis; Gehirn; HRM; Hirnforschung; Humankapital; Integratives Coaching; Lebensberatung; Lebenshilfe; Lernen; Management; Neurobiologie; Neuropsychologie; Neuroscience; Neurowissenschaft; Organisation; Organisationsberatung; Organisationsentwicklung; Organisationslehre; Partnerübung; Personalberatung; Personalentwicklung; Persönlichkeit; Persönlichkeitsentwicklung; Persönlichkeitsveränderung; Psychologie; Psychologische Beratung; Psychotherapieforschung; Systemische Therapie; Team; Team-Coaching; Team-Workshop; Training; Wirtschaftspsychologie, Fachschema: Bildung~Biopsychologie~Psychologie / Biopsychologie~Neurologie~Neurologie / Neurophysiologie~Neurophysiologie~Physiologie / Neurophysiologie~Neurowissenschaft~Pädagogik, Fachkategorie: Biopsychologie, Physiologische Psychologie, Neuropsychologie~Pädagogik~Neurologie und klinische Neurophysiologie, Warengruppe: HC/Psychologie/Psychologische Ratgeber, Fachkategorie: Neurowissenschaften, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Klett-Cotta Verlag, Verlag: Klett-Cotta Verlag, Verlag: Klett-Cotta, Länge: 214, Breite: 135, Höhe: 32, Gewicht: 478, Produktform: Klappenbroschur, Genre: Geisteswissenschaften/Kunst/Musik, Genre: Geisteswissenschaften/Kunst/Musik, Vorgänger: 4556151, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0012, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,38,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.